
Voilà, l’EMDay 2026, c’est fini ! Deux jours de conférences et d’ateliers les 8 et 9 octobre à Biarritz et, comme d’habitude, beaucoup (trop ?) de notes. Avant de vous en livrer un résumé, un petit mot sur l’ambiance.
Je me souviens, quand j’étais encore dans le comité d’organisation, nous avions eu une discussion de fond : est-ce que l’Email Marketing Day doit avant tout rester un événement convivial, ou devenir un salon avec des stands en plus des conférences, et l’objectif d’attirer plein de monde ? Le choix avait été fait de conserver un esprit “barbecue” plutôt que de devenir un peu plus corporate. C’est bien pour ça que l’un des grands attraits de l’EMDay, en plus des ateliers et des conférences, ce sont ses soirées mémorables. Cette année, c’était tout pareil : trois soirées (je n’ai participé qu’à deux d’entre elles) pour discuter avec le microcosme de l’email de manière détendue. Et clairement, c’est ce qui fait la force de l’événement, son identité.
Néanmoins, petite déception sur cette édition. Le cadre de Biarritz et du Connecteur (le lieu de l’événement) est toujours aussi incroyable, mais y être deux années de suite n’a sans doute pas aidé à renouveler l’assistance. Il y avait une bonne partie des habitués, mais il a manqué de diversité, de personnes plus opérationnelles, d’annonceurs. C’était donc un peu moins riche de ce point de vue.
Pour avoir participé à l’orga, je sais aussi que ce sont des paramètres extrêmement difficiles à contrôler. Chapeau bas à toute l’équipe, et particulièrement à Laurent Garnier (local de l’étape) pour tout le travail fourni !
Plutôt que de tout dérouler dans l’ordre, j’ai regroupé ce que je retiens par grands sujets. Sauf la session de Charles Boone, que je garde pour la fin.
Délivrabilité : des confirmations, pas de surprises
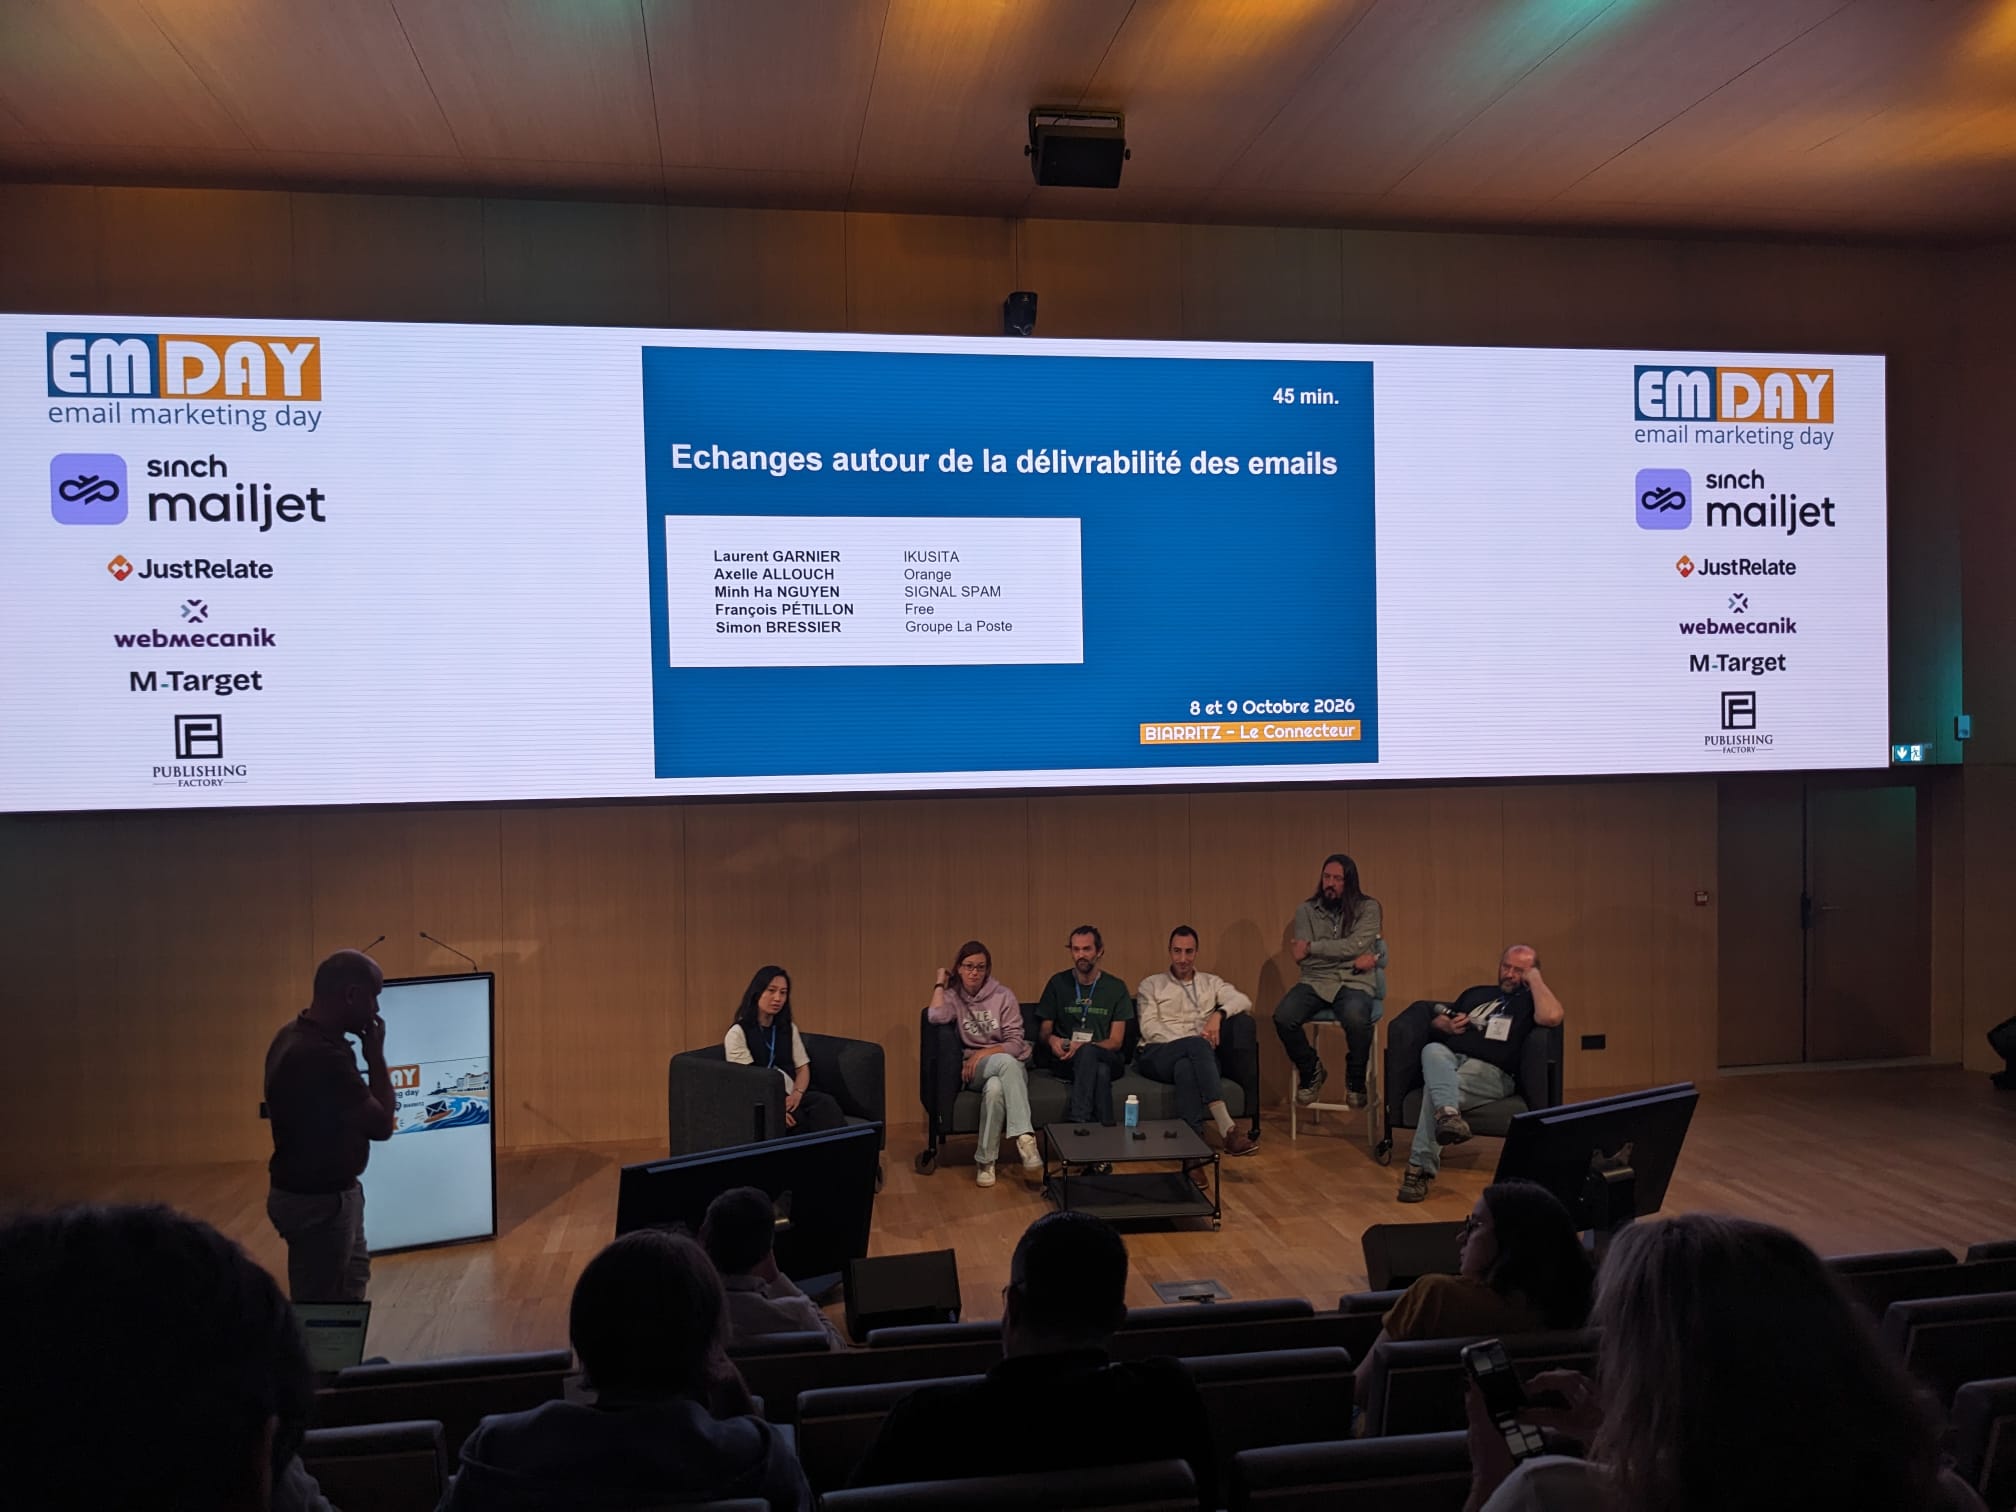
Vendredi matin, la traditionnelle table ronde réunissait Laurent Garnier (Ikusita), Axelle Allouch (Orange), Minh Ha Nguyen (Signal Spam), François Pétillon (Free), Simon Bressier (La Poste) et Baptiste Guerre (Batch). Une session toujours riche d’enseignements, même si l’on sent bien que les évolutions sont contraintes par le cadre budgétaire des fournisseurs de boîtes email français. Les avoir sur scène permet surtout de confirmer le sens que prend la délivrabilité. En vrac :
- Seuils de plaintes : Orange vise toujours 0,3%. On est à 0,6% aujourd’hui, sans doute 0,5% d’ici la fin de l’année. Chez La Poste, on est à 0,5%, prochaine étape à 0,45%, puis descente très progressive jusqu’à 0,3%. La fraude étant bloquée depuis longtemps chez La Poste, ces baisses touchent maintenant des expéditeurs légitimes
- Orange travaille aussi sur la réputation long terme, avec du rate limiting calé dessus et des codes de bounce spécifiques, nouveaux domaines compris (eux ont d’ailleurs des seuils de plaintes plus stricts). Le nouveau webmail arrive fin 2026 avec un dossier promo… pas activé par défaut. Et les adresses wanadoo inactives vont bientôt être désactivées (OFR416)
- La Poste archive les boîtes au bout de 4 mois d’inactivité : les adresses restantes sont donc plus réactives… et se plaignent plus. Par contre, son dossier promo génère beaucoup moins de plaintes que l’inbox et il est plutôt bien accueilli par les utilisateurs
- Free fait cohabiter 3 architectures et laisse du coup très largement la main à Vade. Qui justement (Hornet Security, désormais Proofpoint) n’a encore rien changé à son filtrage depuis le rachat. Ses deux chantiers : intégrer les volumes de plaintes par destinataire pour un même expéditeur (le bâton) et une prime à la stabilité pour ne pas traiter les infras stables comme des flux purement malveillants (la carotte)
- Signal Spam refond toute son infra de feedback loops : aux flux par IP vont s’ajouter des flux par domaine (DKIM), d’autres sont en discussion. Le Feedback ID sera enregistré, sans décision à date sur la manière de l’exploiter et de l’exposer dans les flux de données
- SFR : les domaines historiquement exploités par SFR vont disparaître, à surveiller d’ici 2 à 3 ans
Globalement, on reste dans la droite ligne des règles de Yahoo et Google, et des sujets déjà évoqués l’an dernier. Pas de surprises donc, mais des confirmations. Et même avec uniquement des messageries françaises, ça bouge sans cesse. Il faut suivre !
La veille, Yves-Marie Le Pors-Chauvel (Postmastery) s’était lancé dans la vulgarisation de trois acronymes que l’on entend partout (enfin, quand on s’intéresse à la délivrabilité). ARPF est un rapport agrégé des performances d’envoi (classement inbox ou indésirable, engagement positif, neutre ou négatif), déclaré dans le DNS avec le même sélecteur que DKIM, mais actif uniquement chez Comcast à date. DKIM2 veut corriger les faiblesses de DKIM (replay, forwards, gestion des bounces) avec une signature à chaque étape de la livraison : énormément de travail côté MTA, ESP, MBP et filtres anti-spam, donc de l’expérimental pour les prochaines années, avec une période de transition longue. DMARCbis, lui, est déjà là (la RFC est publiée) et c’est globalement pareil : les anciens enregistrements fonctionnent toujours, les tags obsolètes ne sont simplement plus pris en compte.
Une session qui devait être de la vulgarisation, mais les non-techniciens ont quand même dû bien s’accrocher à leurs slips 😀 Néanmoins, un super résumé de trois sujets dont nous allons entendre parler pendant des mois, voire des années. Pour les acteurs français, c’est clairement DMARCbis qui doit être le focus (La Poste l’a d’ailleurs évoqué le lendemain), sachant que beaucoup sont encore à la ramasse sur DMARC tout court (côté expéditeurs d’email).
Dernière session délivrabilité, vendredi après-midi : Clea Moore (Yahoo) et Sanda Schubert (Eco-CSA) sur l’impact de l’IA. Message principal : tous les signaux historiques restent indispensables (authentification, plaintes, désinscriptions, permission, hygiène de liste, alignement des domaines) et l’IA ne change rien à ces responsabilités. Pour éviter le spam, ne cherchez pas à cacher quoi que ce soit, ni dans le contenu, ni dans la stabilité de vos paramètres d’envoi (“don’t try to game the system”). J’ai pris pas mal de notes, même s’il n’y a pas eu de grandes révélations. Ce qui m’a marqué, c’est qu’on parle autant de clarté des contenus dans une intervention délivrabilité : écrire pour plaire à l’IA ou à l’humain ? Ni l’un ni l’autre, un message clair et une action claire (ça va plaire à Marion Duchatelet). Nous qui prônons en permanence la rédaction en langage clair dans l’emailing, ça fait du bien ! Point bonus pour une intervention non française, ça rafraîchit aussi.
Cet article est en accès libre.
Il nous a demandé du temps et de l’expertise !
Ce mois-ci, merci à nos clients-sponsors : Actito, Adeo Services, AG2R La Mondiale, BPI France, Cardif, Citeo, Clarins, CMI France, Engie, France Télévisions, Le Parisien, Les Echos, Les Furets, Pierre Fabre, Sysco, UMR, Voyageurs du monde… Grâce aux missions qu’ils nous confient, nous pouvons rédiger et partager du contenu gratuit. Ils soutiennent notre travail d’éducation pour promouvoir un email plus responsable. Devenez client et bénéficiez de notre expertise tout en soutenant la production de connaissances ouvertes.
Pixel de tracking : une précision orale qui contredit la FAQ
C’était la session la plus attendue : Alice Darmon (CNIL), Laurent Garnier (Ikusita) et Laurent Caron (avocat) sur les recommandations pixel de tracking email. La CNIL est intervenue suite à des plaintes : le pixel existe depuis des années, mais les personnes n’en ont pas conscience. Deux objectifs, la transparence (que les gens sachent pour pouvoir décider) et la maîtrise de la donnée (qu’ils puissent accepter ou non le pixel). Pour rappel, le consentement dépend de la finalité : pas besoin de consentement pour la délivrabilité, consentement obligatoire pour le marketing et la publicité.
L’exemption délivrabilité vient de la directive ePrivacy, si le pixel est strictement nécessaire au service, la CNIL considère qu’il est légitime de mesurer l’ouverture pour nettoyer les listes de contact ou réduire la pression en stockant la date de dernière ouverture. Par contre, et c’est une info capitale : selon Alice Darmon de la CNIL, passer l’identifiant de campagne dans un pixel exempté n’est absolument pas prévu, sauf à prouver qu’il est strictement nécessaire pour fournir le service demandé par le destinataire (et ça va être vraiment chaud à prouver). Ce qui reste possible en anonymisation, c’est donc un taux d’ouverture par jour et par domaine de destination, pas par campagne.
Côté liens traçants, ePrivacy demande déjà un consentement (même si la CNIL n’a pas sorti de recommandation spécifique), et rien n’empêche une case à cocher commune avec le pixel, puisque le consentement se donne par finalité.
Cette session m’a fait prendre conscience d’une chose : le vocabulaire de la CNIL est en décalage avec celui des praticiens de l’emailing. Par exemple, “taux d’ouverture” y est régulièrement utilisé pour dire “événement d’ouverture”.
Et surtout, par rapport aux analyses que nous avons menées ces derniers mois chez Badsender, elle a apporté une précision importante : selon la CNIL, l’anonymisation des taux d’ouverture au niveau campagne pour les contacts qui n’ont pas donné leur consentement n’est pas possible via le pixel exempté pour raison de délivrabilité. Problème, la question 6 de sa FAQ du 22 juillet dit l’inverse. Nous avons demandé une clarification. En attendant, les plateformes et acteurs qui ont joué la prudence ont sans doute fait le bon choix.
Le sujet a aussi largement occupé l’atelier juridique du forum ouvert de jeudi, avec Laurent Caron et Laurent Garnier. Les discussions ont surtout tourné autour d’une harmonisation européenne qui éclate en interprétations différentes dans chaque marché, et des intérêts très différents entre les plateformes (qui ont tout intérêt à l’harmonisation) et les annonceurs (qui veulent appliquer en minimisant l’impact). On a aussi noté que beaucoup de marques essaient de ranger la plupart de leurs usages sous la finalité “personnalisation”. Atelier très intéressant, même s’il n’est jamais allé sur le terrain des autres contraintes juridiques du CRM : contenu, accessibilité, greenwashing… Le consentement prend toute la lumière, alors qu’il reste énormément d’incompréhensions à lever auprès des pros de l’email. Pour une prochaine fois, une table ronde qui ferait le tour des différents sujets juridiques de l’emailing serait vraiment intéressante.
Enfin, Sinch Mailjet proposait un atelier sur le suivi d’emails en 2026 : un petit sondage sur les pratiques de la salle, un rappel RGPD, puis des groupes chargés de dire si différentes propositions étaient conformes, non conformes ou à adapter. J’ai particulièrement apprécié de me retrouver dans un “vrai” atelier. Le temps d’intelligence collective était court, mais il a eu le mérite de faire discuter les participants entre eux. Pas un atelier d’experts, mais un atelier qui force l’audience à plonger dans le sujet sans rester passive. Vraiment appréciable !
IA : entre utilisation sauvage et démos qui marchent
Autre atelier du forum ouvert, l’IA avec Romain Didier et Ronan Pellegrini. Les questions de départ étaient larges (des emails générés par l’IA lus par des IA, comment éviter un contenu insipide, l’itération de contenus et de visuels), mais la discussion est assez vite partie sur la génération de contenu. Avec une précaution partagée autour de la table (ou plutôt dans les canapés) : il s’agit des expérimentations de chacun, pas forcément de bonnes pratiques. Quelques idées intéressantes, comme nourrir l’IA avec le fonds éditorial historique pour retrouver l’identité de l’auteur, flagger les contenus générés par IA dans le corpus, ou consigner les retours humains sur ces contenus (ils ont beaucoup de valeur, voire plus que les contenus créés sans IA). Et une vraie question en suspens : comment vont monter en compétence les juniors ?
On a aussi parlé de l’AI Act et des mentions obligatoires sur les contenus générés. Peu de personnes étaient au courant, et personne n’a mis en place de marqueurs dans ses emails. Bref, on sent que la maturité et la prise de recul sur les pratiques ne sont pas encore très avancées. L’arrivée de contenus synthétiques dans les corpus d’apprentissage n’est pas dans les têtes, l’AI Act non plus. L’IA part dans tous les sens, ça reste de l’utilisation sauvage avec très peu de cadre.
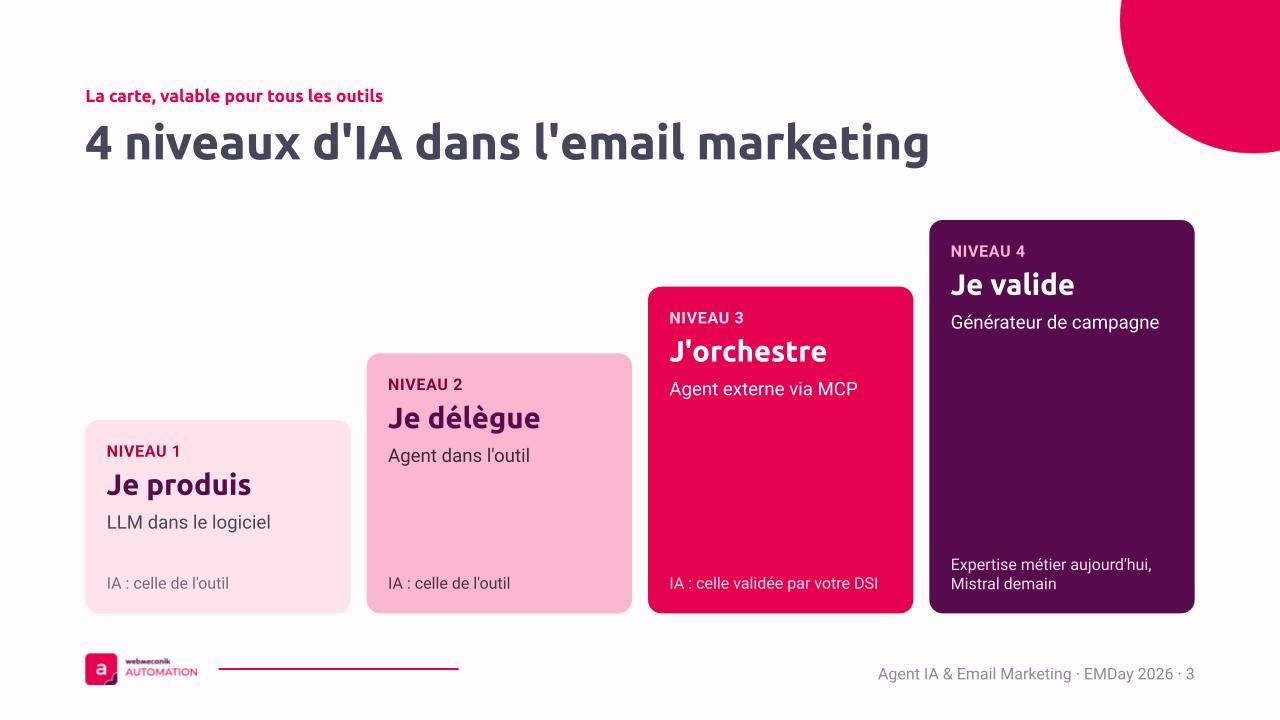
À l’inverse, la session de Norman Pracht (Webmecanik) sur les agents IA était très concrète. Il a présenté quatre niveaux d’IA dans l’emailing : je produis (le LLM dans le logiciel métier), je délègue (un agent dans l’outil), j’orchestre (un agent externe via MCP, c’est l’IA de l’entreprise qui travaille) et je valide (génération de campagnes à partir d’expertises métier et d’une base de connaissance, via le Mistral de Webmecanik). Le tout avec des démos fonctionnelles dans leurs outils, ce qui montre très concrètement comment les processus de création sont en train de radicalement évoluer. Certains concepts ne sont plus de belles promesses ! La discussion de fin a d’ailleurs porté sur le remplacement progressif de certaines interfaces par des chats de LLM connectés via MCP aux outils de l’entreprise. Et ça m’a fait penser que certaines entreprises qui ont pris un peu de temps à l’arrivée de l’IA se retrouvent avec des concepts beaucoup plus intéressants, parce qu’elles n’ont pas à faire évoluer un legacy encombrant.
RCS : il serait temps d’arrêter les “campagnes RCS”
Vendredi matin, table ronde RCS avec Stéphane Miquelis (Orange), Romain Didier (Smartprofile), Thibault Bourillon (High Connexion), Laurent Baccilleri (M-Target) et Christophe Collier (Sinch). Le message général : voir le RCS en complément de l’email. Mais il a fallu attendre le quatrième intervenant pour parler de l’aspect conversationnel, et la plupart en étaient encore à comparer les canaux et à qualifier ce qu’est le RCS. C’est finalement Romain Didier qui a amené les scénarios et l’orchestration, avec un point intéressant : attention à doser la pression en fonction de l’historique d’interaction. Et le conversationnel n’est pas forcément en push, il peut être en pull (Google propose maintenant des CTA dans le search pour démarrer une conversation).
Dommage que cette table ronde ait été animée par l’une des personnes qui a le plus à gagner commercialement à promouvoir le RCS. Ce qui est bien dans une table ronde, c’est quand il y a un peu de débat, de piquant, de challenge ! Il est évident que le RCS va devenir durablement un canal du mix de l’activation CRM. Mais il n’est pas exempt de désavantages et gagnerait clairement à être présenté pour ce qu’il est : un des acteurs du mix CRM, complémentaire aux autres. L’intégration native aux solutions de gestion de campagnes CRM fera très certainement la différence dans les prochains mois.
Des développeurs et un annonceur sur scène (enfin !)
Courte, mais chouette intervention de Thomas Lamothe (Mailjet) sur la manière de rester pertinent auprès des développeurs. Il remet au centre la place du dev dans l’email, avec les différents outils pour manipuler une plateforme (API, librairies et aujourd’hui MCP) et le rôle de l’open source, MJML en tête. MJML 6 est d’ailleurs en approche, avec de l’accessibilité et plus de flexibilité côté design grâce à une nouvelle manière de générer le HTML. Évidemment, l’IA est un sujet important dans ce cadre.
Et puis, enfin, une session durant laquelle un annonceur est venu raconter une expérience terrain ! Oscar Penserini et Vincent Diana ont présenté la refonte du MTA de Leboncoin, qui envoie environ 12 millions d’emails par jour (4 milliards par an, 58% de transactionnels et 42% d’emails de messagerie). Au départ, de vieux serveurs Postfix qu’une seule personne maîtrisait encore, et environ 1 million d’emails perdus par jour… signalés par les utilisateurs plutôt que par les équipes. Ils sont passés à PowerMTA, ont transféré un bloc d’adresses IP /24 de leur data center vers AWS (procédure en fait assez simple côté AWS), préchauffé les IPs, et basculé tout le trafic en 8 mois, pour des coûts d’infra d’envoi passés de 14k à 17k par an. Résultat : un taux de bounce passé de 0,9% à 0,2% (septembre 2026), un système de capping pour éviter de flooder les utilisateurs, trois tentatives maximum sur les boîtes pleines avant d’arrêter les envois… et surtout, toute l’équipe comprend maintenant comment ça marche. Un duo jeune et dynamique, une présentation pas du tout corporate, qui a rafraîchi le programme. Exactement le type de profil qui manquait un peu dans la salle cette année.
Les gourous de l’email sur LinkedIn, on en parle ?
Jeudi, Yves-Marie Le Pors-Chauvel ouvrait le bal avec un titre qui annonçait la couleur : “beaucoup de likes, beaucoup de bullshit”. Tous ses exemples avaient moins de 6 mois. Petit florilège des profils passés en revue :
- les “nouveautés” qui sont en fait des pratiques existantes depuis plusieurs années
- les micro tips (sur le DKIM fail de Microsoft, par exemple) qui ne fonctionnent que dans des cas très particuliers
- les catastrophistes, pour qui le consentement au pixel de tracking sera forcément une catastrophe
- celui qui “connaît les règles de Gmail” et vous explique que DMARC à none envoie en spam
- les fans de l’email full image, qui marcherait mieux… sauf quand on creuse 😀
- celui qui n’y connaît rien mais qui sait utiliser l’IA (“J’ai passé six semaines à…”), pour vendre des liens d’affiliation
Son point : être expert délivrabilité, ça veut dire être confronté au quotidien aux problèmes, expérimenter l’actualité et les changements. C’est vrai qu’il y a beaucoup de bullshit de pseudo-experts sur LinkedIn. Le plus frustrant, c’est qu’ils récoltent beaucoup plus de visibilité que les experts qui ont la tête dans des sujets très concrets. Pour autant, plutôt que de nous concentrer sur ce qu’ils racontent, nous ferions sans doute mieux de continuer à diffuser du contenu de qualité, basé sur nos expériences de terrain. Peut-être que nous ne ferons jamais autant de likes qu’eux. Mais au moins, nous continuerons à rassembler une communauté qui cherche des contenus sérieux.
Le freestyle de Charles, pour finir
Charles Boone (Wefficient) était de retour sur scène après quelques années. Il devait clôturer la journée, il a finalement été intercalé avant Clea Moore… mais dans ce compte rendu, il garde la dernière place (la meilleure ici) ! Le débit était tellement rapide que j’ai préféré écouter plutôt que de prendre des notes. Sur la forme, une présentation bourrée de références culturelles et technologiques. Sur le fond, comme d’habitude, une alerte sous forme de prévision, entre la prospective et la boule de cristal.
Le sujet : les IA sont partout, nous leur donnons plein de pouvoirs, y compris dans nos boîtes email. C’est la porte grande ouverte à des attaques de plus en plus sophistiquées, dans lesquelles des IA trompent d’autres IA. À grand renfort d’exemples concrets qui ont déjà eu lieu, Charles nous fait peur… mais au fond, nous sommes tous conscients que c’est déjà en route, déjà là. À nous, humains, de penser en permanence aux données que nous acceptons de fournir et aux autorisations que nous donnons à l’IA pour agir à notre place et en notre nom.
C’est aussi une alerte pour les marketeurs : les citoyens sont de plus en plus conscients de ces risques et donnent de moins en moins de données fiables aux entreprises. À méditer.
À l’année prochaine !

Laisser un commentaire